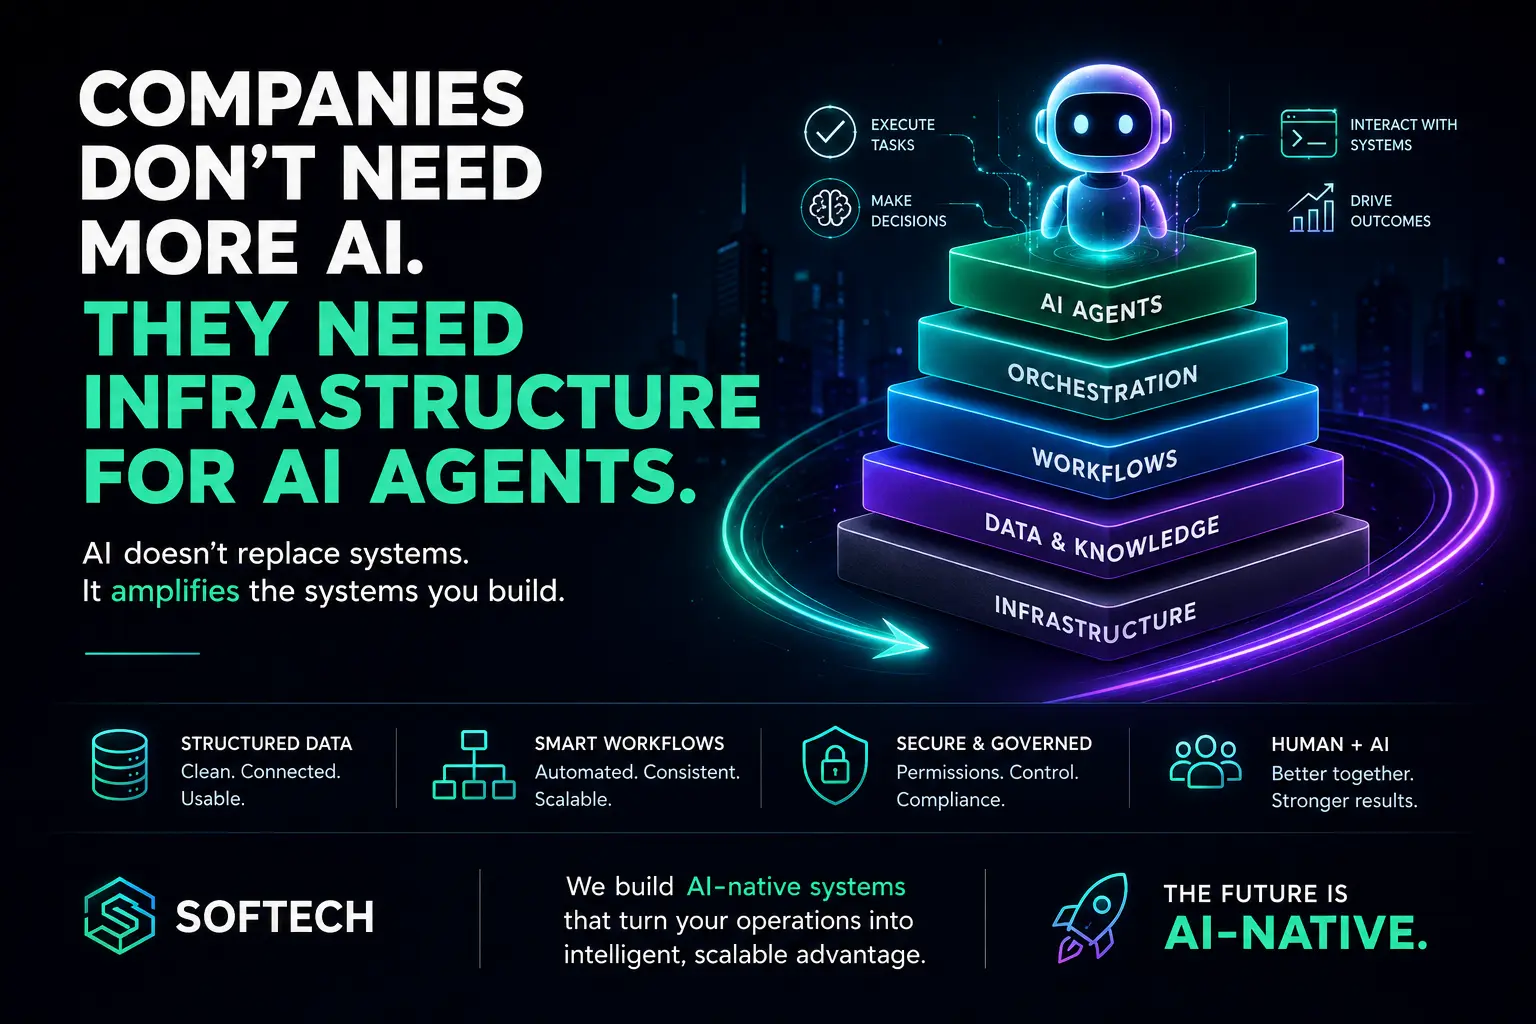
AI-native SaaS to architektura aplikacji, a nie funkcja modelu
Produkcyjny AI-native SaaS nie polega na postawieniu modelu językowego obok aplikacji i przekazaniu mu szerokiego dostępu do bazy. AI powinno działać jako jeden z subsystemów wykonawczych wewnątrz tych samych granic tenantów, permissions, workflow i audytu, które obowiązują działania człowieka. Model może interpretować intencję, klasyfikować dane, przygotować treść lub zaproponować akcję; to aplikacja nadal decyduje, jakie dane wolno odczytać, jakie operacje można wykonać i która zmiana stanu jest prawidłowa.
Ta różnica staje się krytyczna, gdy AI robi coś więcej niż odpowiadanie na pytania. Model, który może utworzyć fakturę, zmienić rezerwację, zainicjować refund, zaktualizować CRM albo przygotować dokument compliance, uczestniczy już w stanie biznesowym. Wtedy głównym problemem architektonicznym nie jest prompt, lecz authorization, idempotency, approval, observability i recovery.
Praktyczna architektura referencyjna
Dobry model rozdziela application control plane od AI reasoning layer. Control plane odpowiada za identity, tenant context, reguły domenowe, workflow state i persistence. Warstwa AI otrzymuje celowo zbudowany context i może żądać wyłącznie jawnie zarejestrowanych tools.
| Warstwa | Odpowiedzialność | Czego AI nie powinno kontrolować |
|---|---|---|
| Identity & tenant | User, organization, membership, resource scope | Wymyślania lub przełączania tenant context |
| Policy | Role, permissions, resource-level rules | Nadawania sobie permission na podstawie promptu |
| Domain | Poprawne commands i state transitions | Dowolnych zapisów do bazy |
| AI | Interpretacja, planowanie, drafting, recommendation | Omijania domain validation |
| Tools | Wąskie adaptery do capabilities produktu | Nieograniczonego generic access |
| Audit | Kto, co, dlaczego, wynik i evidence | Opcjonalnego logowania best-effort |
Tenant context powinien pochodzić z serwera
Organization ID, membership, role i resource scope powinny wynikać z uwierzytelnionego stanu aplikacji, a nie z tekstu przekazanego modelowi. Jeżeli użytkownik poprosi asystenta o przełączenie na innego klienta albo dokument zawiera identyfikator obcej organizacji, można to potraktować jako intencję, ale nie jako authorization. Serwer rozwiązuje żądany obiekt, sprawdza membership i dopiero wtedy udostępnia minimalny potrzebny context.
Ta sama zasada dotyczy retrieval. To, że rekord trafił do contextu modelu, oznacza wyłącznie, że wybrała go warstwa retrieval. Nie daje to automatycznie prawa do jego zmiany, eksportu ani ujawnienia. Read scope i action scope powinny być oceniane oddzielnie.
Tools powinny przypominać domain commands
Najbezpieczniejszy tool surface wygląda jak dobrze zaprojektowany application service: createDraftQuote, rescheduleReservation, requestRefundReview czy classifyInspectionIssue. Każdy tool przed wykonaniem waliduje tenant scope, input schema, bieżący stan i permission. Należy unikać narzędzi typu run SQL, update object albo call arbitrary URL, chyba że działają w odrębnej, administracyjnej granicy bezpieczeństwa.
Dla side effects tools powinny wspierać idempotency. Retry modelu, sieci i workera mogą inaczej doprowadzić do podwójnych faktur, maili lub wywołań zewnętrznego API. Stabilny command key powiązany z operacją biznesową pozwala warstwie domenowej zwrócić poprzedni wynik zamiast powtarzać efekt.
Workflow state powinien pozostać deterministyczny
AI dobrze interpretuje niejednoznaczne informacje, a deterministyczne state machines dobrze egzekwują proces. Praktyczny wzorzec pozwala modelowi zaproponować kolejną akcję, ale aplikacja waliduje, czy jest ona legalna z aktualnego stanu. Umowa może przejść z draft do review wyłącznie przez workflow domenowy. Refund o wysokiej wartości może zawsze wymagać approval, niezależnie od pewności modelu.
Dzięki temu human-in-the-loop staje się jawny. Approval nie powinien oznaczać ogólnego promptu zapytaj człowieka, gdy nie jesteś pewny. To decyzja policy: operacje przekraczające próg ryzyka tworzą task review, zachowują propozycję modelu i evidence oraz oczekują na osobę z odpowiednim permission.
Observability musi łączyć zachowanie AI z wynikiem produktu
Model latency i token cost są przydatne, ale niewystarczające. Telemetria produkcyjna powinna łączyć run z tenantem, workflow, tool calls, decyzjami policy, retries, human overrides i końcowym rezultatem biznesowym. Dzięki temu można odpowiedzieć: który tool najczęściej zawodzi, gdzie użytkownicy nadpisują rekomendację, która automatyzacja oszczędza czas, ale zwiększa liczbę zgłoszeń, oraz który tenant generuje nieproporcjonalny koszt inference.
Nie należy domyślnie logować sekretów ani pełnych promptów. Lepiej przechowywać strukturalne events i zredagowane evidence adekwatne do modelu prywatności produktu. Audit ma wyjaśniać akcję biznesową, a nie tworzyć drugą niekontrolowaną kopię danych klienta.
Failure modes, które trzeba zaprojektować przed startem
- Cross-tenant context leakage: retrieval lub cache keys nie zawierają tenant scope.
- Authorization confusion: model uznaje odczyt danych za permission do działania.
- Duplicate side effects: retries wykonują mutację więcej niż raz.
- Stale-state actions: model działa na snapshot, gdy inny użytkownik zmienił już zasób.
- Over-broad tools: generic capability zwiększa blast radius błędu promptu.
- Invisible degradation: jakość modelu zmienia się bez task-level evals i business telemetry.
Jak wygląda to w pracy produktowej Softech
W marketplace, booking, field-service i systemach operacyjnych powtarza się ten sam trwały wzorzec: AI daje wartość, kiedy jest podłączone do istniejącego source of truth, a nie gdy go zastępuje. W marketplace KILOGRAM AI może wspierać listing composition, a listing lifecycle pozostaje deterministyczny. W Voice AI booking model interpretuje rozmowę, a availability, pricing i utworzenie rezerwacji pozostają domain operations. W TECHPRES.app measurements, assets i protocols pozostają audytowalnym operational state mimo rozwoju warstwy AI.
Dlatego w Softech Web & SaaS Product Engineering oraz AI Automation spotykają się właśnie na granicy architektury: modele są integrowane ze stanem produktu, a nie wdrażane jako równoległa aplikacja.
Checklist architektoniczny
- Zdefiniuj canonical tenant i user context przed model call.
- Oddziel permission do retrieval od permission do mutation.
- Udostępniaj wąskie domain tools zamiast generic infrastructure access.
- Zapewnij idempotency i walidację bieżącego state dla side effects.
- Zapisz progi approval w product policy, nie tylko w promptach.
- Rejestruj strukturalny audit dla decyzji modelu, tools, policy i człowieka.
- Mierz task success i business outcome obok metryk modelu.